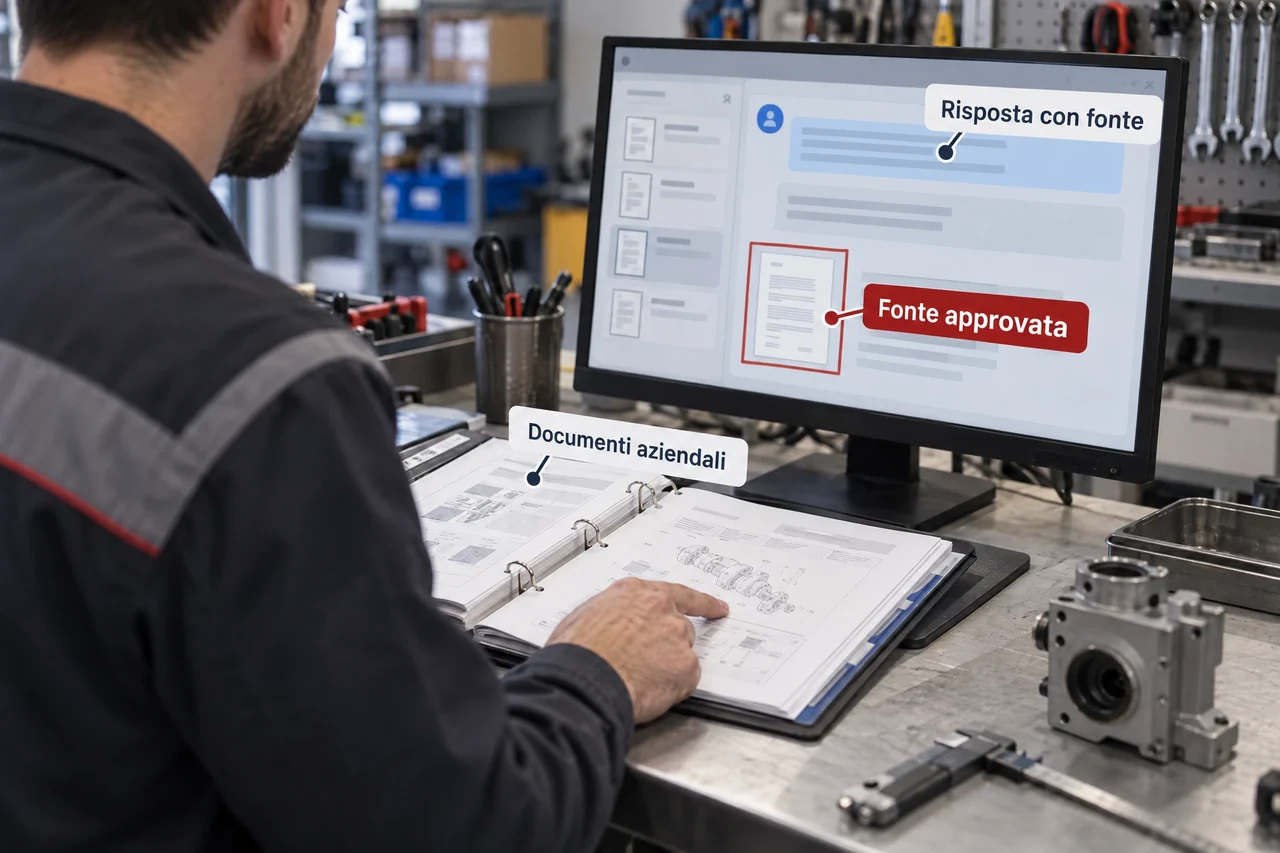
Questo è il criterio con cui valutare un chatbot AI su documenti aziendali. Il sistema deve aiutare a cercare e spiegare, ma non diventa l’autorità che decide da sola quale regola applicare. La responsabilità di scegliere le fonti, definire i ruoli e verificare gli output resta dell’impresa.
Che cosa fa un RAG, in parole semplici
RAG significa Retrieval-Augmented Generation. Alla domanda di un utente, il sistema cerca prima passaggi pertinenti in una raccolta documentale e li passa al modello che formula la risposta. La ricerca che ha introdotto questo approccio combina la conoscenza del modello con una memoria esterna recuperabile; indica anche provenienza e aggiornamento della conoscenza come problemi da risolvere, non come funzioni garantite in ogni prodotto. La pubblicazione originaria sul RAG aiuta a cogliere la differenza: il recupero delle fonti è una parte del sistema, non una promessa che ogni frase sia esatta.
In pratica ci sono cinque passaggi. Si scelgono i documenti ammessi; si estrae il testo, anche da scansioni se è leggibile; il testo viene spezzato in porzioni ricercabili; ogni porzione riceve metadati, come titolo, versione e livello di accesso; infine, alla domanda, il sistema recupera solo le porzioni candidate e costruisce una risposta. Una citazione con documento e punto preciso non nasce automaticamente: va progettata e poi controllata.
Un RAG è adatto a domande come: quale procedura interna vale per questa eccezione?, quali documenti servono per aprire una pratica? oppure in quale sezione del manuale è descritta questa configurazione?. È meno adatto se la risposta dipende soprattutto da un giudizio nuovo, da una decisione riservata a un responsabile o da dati che non esistono nelle fonti. In questi casi il chatbot dovrebbe dichiarare il limite e indicare il passaggio umano, non completare il vuoto con una risposta plausibile.
Partire dalle domande, non dall’archivio intero
Prima di scegliere strumenti, raccogli dieci o quindici domande che il team ripete davvero. Devono essere domande per cui esiste una fonte consultabile e un destinatario legittimo. Per ciascuna, annota chi la pone, quale documento dovrebbe sostenerla, chi ne è proprietario e che cosa accade se la risposta è sbagliata. Questa piccola mappa rivela presto se il primo perimetro può essere, ad esempio, l’assistenza tecnica interna invece dell’intero patrimonio documentale.
Definisci anche ciò che il chatbot non deve fare. Può essere opportuno escludere approvazioni di spesa, istruzioni vincolanti su sicurezza o contratti, valutazioni individuali e documenti che il personale non consulta in modo ordinario. Escludere un caso non è un limite del progetto: è un modo per assegnare una regola chiara di escalation. Un sistema che risponde non trovo una fonte approvata; coinvolgi il referente può essere più affidabile di uno che risponde sempre.
Il primo pilota dovrebbe avere un proprietario di processo riconoscibile. Non basta chi sa usare la piattaforma: serve chi può decidere se una procedura è superata, risolvere conflitti tra due fonti e autorizzare un aggiornamento. Senza questo ruolo, gli errori dell’archivio tendono a diventare errori più veloci.
Preparare fonti che il chatbot possa mostrare
La qualità della risposta inizia prima del modello. Per ogni file ammesso, registra in un elenco semplice: titolo leggibile, area proprietaria, versione o data di efficacia, stato valido/superato/in revisione, pubblico autorizzato e riferimento alla posizione originale. Se un manuale è sostituito, non basta caricare la nuova copia: la precedente va contrassegnata o rimossa dal perimetro di recupero secondo la politica definita.
È utile dare priorità a procedure approvate, manuali con revisione identificabile, listini validati e FAQ mantenute da un responsabile. Sono invece candidati deboli le bozze prive di proprietario, allegati duplicati, vecchie presentazioni, file con nomi ambigui e conversazioni esportate senza contesto. Un PDF bello da leggere ma senza versione può produrre una risposta difficile da contestare. Un documento breve, datato e approvato è spesso una fonte migliore.
Tratta i nuovi file come input da verificare. OWASP segnala che, nei sistemi che usano vettori ed embedding per il RAG, contenuti non verificati possono manipolare gli output e controlli disallineati possono esporre informazioni sensibili. La sua indicazione pratica è validare le fonti, accettarle da origini fidate, classificarle e mantenere tracce delle attività di recupero. La guida OWASP sulle debolezze di vettori ed embedding è un riferimento utile per trasformare questa cautela in un controllo di ingresso.
Per fonti complesse, controlla anche l’estrazione del testo. Tabelle, note, intestazioni ripetute e testo nascosto possono cambiare il senso di una regola dopo la conversione. Prima di indicizzare, confronta alcuni passaggi estratti con l’originale e verifica che i titoli di sezione rimangano associati al contenuto. Questo controllo richiede poco tempo su un perimetro piccolo e rende più comprensibili le citazioni successive.
La griglia S.E.R.V.E. per decidere se il pilota è pronto
Per evitare una valutazione basata soltanto sulla dimostrazione più riuscita, puoi usare la griglia S.E.R.V.E.. È uno schema operativo proposto qui, non uno standard o una certificazione. Assegna 0 se il punto manca, 1 se è parziale o affidato a conoscenza informale, 2 se esiste un controllo praticabile. Il totale su dieci non misura la conformità normativa: serve a rendere visibili le priorità prima di allargare il perimetro.
| Dimensione | Domanda da porre | Che cosa significa 2 punti |
|---|---|---|
| Scopo | Quali domande deve risolvere? | Domande, utenti e confini sono scritti. |
| Evidenze | Le risposte hanno fonti approvate? | Ogni file ha proprietario, stato e riferimento. |
| Ruoli | Chi può cercare e chi aggiorna? | Gruppi e responsabilità sono assegnati. |
| Versioni | Come si gestisce una modifica? | Esiste un passaggio verificabile per aggiornare o ritirare una fonte. |
| Esame | Come si prova una risposta? | Un set di domande e criteri di esito è conservato. |
Un punteggio basso in una sola voce importante merita attenzione anche se il totale sembra buono. Per esempio, dieci fonti curate non compensano l’assenza di ruoli: il chatbot potrebbe recuperare un passaggio corretto per la persona sbagliata. Allo stesso modo, un buon controllo di accesso non rende valida una procedura non più in vigore.
Permessi e dati personali: il filtro deve agire prima della risposta
Un chatbot documentale non dovrebbe trasformare una ricerca autorizzata in una vetrina più ampia. Definisci gruppi coerenti con il lavoro: per esempio assistenza tecnica, commerciale, amministrazione e responsabili. Poi associa le fonti a tali gruppi e verifica che il recupero consideri il ruolo dell’utente prima di selezionare i passaggi da usare. Nascondere soltanto una citazione nell’interfaccia non risolve il problema se il contenuto era già arrivato al modello.
I documenti aziendali possono contenere dati personali, informazioni commerciali riservate o categorie che richiedono tutele specifiche. Il testo ufficiale del GDPR richiama finalità determinate, minimizzazione, esattezza, limitazione della conservazione e protezione contro trattamenti non autorizzati; l’articolo 25 richiede misure adeguate fin dalla progettazione e, per impostazione predefinita, il trattamento dei soli dati necessari alla finalità. Gli articoli 5 e 25 del GDPR sono un punto di partenza per porre domande concrete, non una scorciatoia per dichiararsi conformi.
Prima del caricamento, chiediti: questa informazione serve davvero alle domande scelte? Può essere sostituita da una versione ridotta o pseudonimizzata? Per quanto tempo deve rimanere disponibile? Chi può esportarla o vederla nei registri? Documenta anche il ruolo dei soggetti coinvolti nel trattamento e le condizioni del servizio scelto. Se il perimetro comprende dossier del personale, dati sanitari, contratti individuali o informazioni di terzi, è prudente coinvolgere chi segue privacy e sicurezza prima del pilota.
Il controllo di accesso va provato con utenti di ruolo diverso. OWASP raccomanda controlli granulari e archivi consapevoli dei permessi, oltre a una separazione logica rigorosa fra insiemi di dati. Non basta verificare che l’utente non trovi il titolo di un file: prova domande indirette, sinonimi e richieste che combinano due temi per vedere se una risposta lascia intuire contenuti non autorizzati.
Far sì che ogni risposta sia controllabile
Una citazione utile non è il nome generico della cartella. Accanto alla risposta, mostra almeno il titolo del documento, la versione o data di efficacia, il capitolo o la pagina e un collegamento che l’utente sia autorizzato ad aprire. Se una risposta usa più fonti, rendi distinguibile quale frase è sostenuta da quale passaggio. Se le fonti sono in conflitto, il chatbot deve esporre il conflitto e indirizzare al proprietario invece di scegliere in silenzio.
Definisci anche una risposta standard per l’assenza di evidenza: non trovo una fonte approvata nel perimetro disponibile. È diversa da non esiste una regola. La prima informa sul limite del sistema; la seconda sarebbe un’affermazione sull’azienda. Il profilo NIST sull’AI generativa raccomanda di confrontare gli output con dati noti, documentare come il sistema dipende dalle fonti a monte e tracciare le modifiche al dataset per mantenere verificabile l’origine dei contenuti. Il profilo NIST AI 600-1 offre criteri utili per questo controllo continuo.
Testare prima con domande difficili
Una demo con due domande facili non è una valutazione. Prepara un set di prova tratto dal lavoro reale e con risposta attesa verificata dal proprietario della fonte. Un esempio puramente ipotetico usa trenta domande: dodici con una risposta chiara nel corpus, sei senza alcuna fonte, sei volutamente ambigue, quattro proposte da utenti con permessi diversi e due legate a una versione superata. La quantità non è una soglia universale: serve a evitare che si provi solo il caso favorevole.
Per ogni domanda, registra quattro esiti separati: la risposta è fedele al passaggio? la citazione porta davvero al punto che la sostiene? il documento era accessibile a quel ruolo? la versione era quella valida? Aggiungi una nota quando il chatbot parafrasa troppo, unisce fonti incompatibili oppure non ammette l’incertezza. Il risultato più utile non è una percentuale isolata, ma l’elenco dei difetti che impediscono un uso sicuro nel processo scelto.
Ripeti una parte dello stesso set quando cambiano documenti, regole di accesso, estrazione del testo o modello. Se una procedura diventa critica, aggiungi al set le domande che più spesso hanno creato dubbi. NIST indica valutazione e monitoraggio successivo al rilascio per intercettare output inattesi e modifiche ai dati; per una PMI questo può tradursi in una breve verifica periodica del proprietario, con una traccia delle correzioni eseguite.
Esempio ipotetico: un perimetro piccolo ma verificabile
Immagina un distributore tecnico che riceve domande ricorrenti su installazione, garanzia e disponibilità di ricambi. Invece di indicizzare ogni file dell’azienda, il primo pilota comprende soltanto manuali tecnici con revisione identificata, la procedura interna di apertura ticket e le condizioni di garanzia approvate. L’area tecnica può consultare manuali e procedura; l’area commerciale può consultare le condizioni di garanzia, ma non le note interne di diagnosi.
Alla domanda quali verifiche servono prima di aprire un ticket?, una buona risposta riassume soltanto i passaggi presenti nella procedura, cita sezione e versione e permette di aprire quel documento se l’utente è autorizzato. Alla domanda il ricambio è incluso?, se le condizioni dipendono dal codice prodotto che non compare nella fonte, il chatbot non dovrebbe dedurre la risposta. Può indicare la clausola generale e chiedere il controllo del referente o della fonte mancante.
Se un manuale nuovo sostituisce il precedente, il proprietario aggiorna l’elenco delle fonti, ricostruisce o aggiorna l’indice secondo il processo scelto e ripete le domande di prova legate al prodotto. Se due documenti riportano istruzioni diverse, la correzione non è modificare la frase generata finché sembra convincente: è chiarire quale fonte è valida e registrare la decisione. Questo esempio descrive un metodo ipotetico, non un caso reale né una configurazione promessa.
Portare il pilota nell’uso quotidiano
Prima di estendere il chatbot a nuovi reparti, verifica che il team sappia riconoscere una citazione incompleta, segnalare una risposta dubbia e richiedere l’aggiornamento di una fonte. Stabilisci un canale interno per gli errori e una regola semplice: chi riceve il problema, chi decide sulla fonte e chi conferma la correzione. I log possono essere preziosi per individuare domande ricorrenti, ma vanno progettati con la stessa attenzione riservata agli altri dati del sistema.
Se il punto di partenza è ancora incerto, può essere utile confrontare il perimetro e i controlli con le soluzioni AI per aziende già descritte sul sito, senza assumere che una tecnologia risolva da sola qualità documentale e autorizzazioni. Il passaggio sensato è scegliere un insieme di domande, fonti e ruoli abbastanza piccolo da essere verificato.
Per ragionare sul tuo caso puoi descrivere volontariamente all’assistente in basso quali documenti usate, chi deve consultarli e quale dubbio ricorrente volete ridurre. Non occorre condividere documenti riservati per iniziare a definire il perimetro.